Velké jazykové modely (LLM – např. OpenAI ChatGPT, Google Gemini, Anthropic Claude apod.) se během krátké doby staly běžnou součástí procesu psané tvorby, včetně oblasti medicíny. Ještě nedávno šlo o technologickou zajímavost, dnes je používají studenti, lékaři, vědci, úředníci, manažeři i pacienti. Pomáhají s e-maily, zápisy, abstrakty, doporučeními, výukovými texty, prezentacemi, stanovisky i s projevy. Tam, kde dříve člověk dlouho seděl nad prázdnou stránkou, dnes během několika sekund dostane návrh, který svou kvalitou dokáže v řadě případů obstát. Napříč informačním prostorem, počínaje sociálními sítěmi a úřední komunikací konče, však v současnosti pozorujeme inflaci množství textu a naředění jeho významu. Příspěvky generované umělou inteligencí (AI) jsou poznat a celý prostor již dnes zahlcují.
reklama
reklama
Algoritmus už umí podle zadání vyrobit celý text, který má hlavu a patu, slušnou strukturu, přiměřený tón a většinou i správnou gramatiku. Pro mnoho lidí je to velká pomoc. Texty jsou v průměru čitelnější. Mizí část stylistické neohrabanosti, kterou jsme dříve běžně vídali v úředních dopisech, studentských pracích, prezentacích nebo pracovních e-mailech. Člověk, který psal nejasně, najednou píše přijatelně. Člověk, který si netroufal na anglický abstrakt, má první použitelný návrh. Zlepšuje se i úprava grafická, v textech i prezentacích.
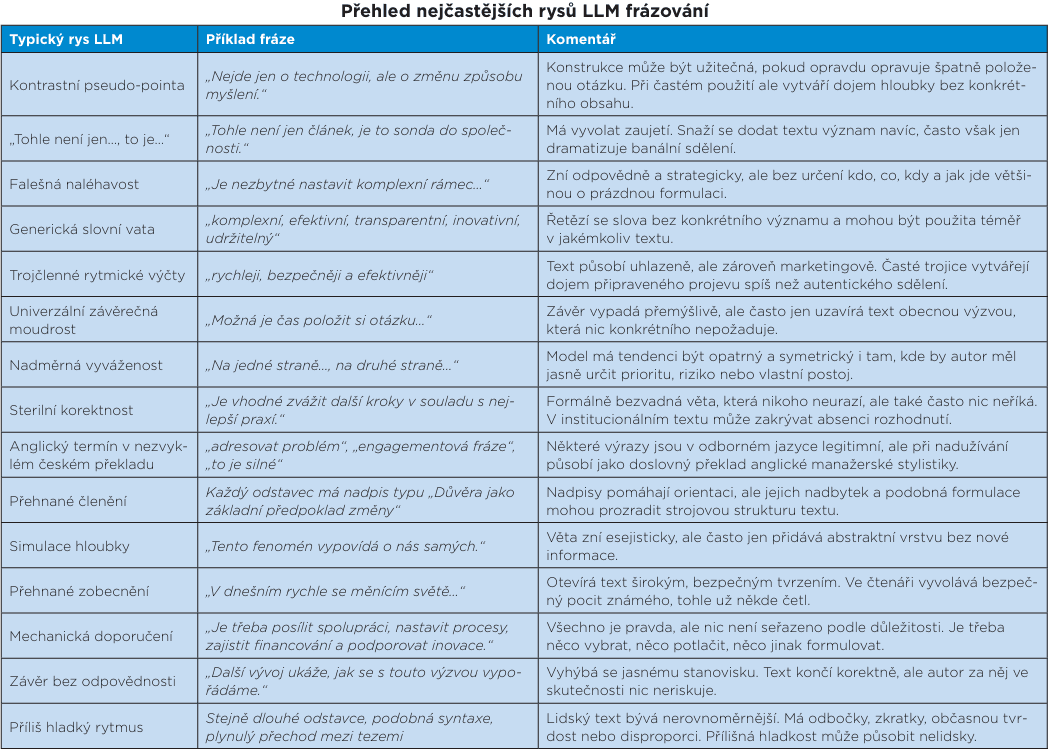
Přijatelných textů postupně přibývá, ale začínají se navzájem podobat. Jsou uhlazené, opatrné, vstřícné, korektní. Často jsou na první pohled lepší než to, co by autor napsal sám. Při jejich čtení však narážíme na určité nezvyklé frázování, užívání výrazů obvyklých v angličtině, které ale v češtině znějí při otrockém doslovném překladu poněkud nepřiměřeně. Setkáváme se také s používáním podobné argumentace, podobným způsobem konstrukce textu, zachytávání čtenářovy pozornosti. Čteme významové oblouky typu „Tohle není jen článek o psaní pomocí LLM, to je hluboká analýza interakce člověk–stroj. A to je silné“. Přes stylistickou čistotu a jasnou argumentaci vidíme mnoho textového balastu. Text bývá členěn do sekcí, každá sekce má nadpis. Je to přehledné, ale bývá tam těch nadpisů moc, jejich formulace jsou zvláštní a budí to pochybnost, zda byly napsány skutečně deklarovaným autorem textu. LLM byly primárně trénovány v angličtině a určitým způsobem také nasály anglosaský způsob práce s jazykem, informacemi a komunikací. Ten se poněkud liší od českých zvyklostí.
Typický text generovaný nebo silně upravený LLM lze poznat i podle dalších jazykových jevů. Často se v něm objevují slova jako komplexní, klíčový, efektivní, transparentní, udržitelný, inovativní, strategický, mezioborový. Ztrácejí svůj význam a stávají se spíše výplní. Vezměme si větu: „Je nezbytné vytvořit komplexní a udržitelný rámec pro odpovědnou implementaci inovativních technologií.“ Na první pohled vypadá dobře. Dá se použít na řadě míst. Jenže když věta pasuje skoro všude, většinou neříká skoro nic. Je to spíše jazyk, který simuluje vážnost.
reklama
Podobné je to s výše zmíněnou formulací „nejde pouze o…, ale o…“. Dobře použitá dokáže opravit špatně položenou otázku. Například u umělé inteligence ve zdravotnictví opravdu nestačí mluvit jen o nákupu softwaru. Podstatné je, kdo systém používá, kdo kontroluje výstup, kdo odpovídá za chybu, jak se řeší neshoda s lékařem a co se stane, když model začne selhávat v běžném provozu. Pak takto formulace přináší nebo reflektuje konkrétní sdělení. Jenže když se stejná konstrukce používá často, stává se rétorickým tikem. Text pak vypadá hlubší, než je.
LLM do psaní přinesly určitou změnu. Dříve bylo možné poměrně snadno poznat špatný text. Byl nepřehledný, kostrbatý, nepohodlný na čtení. Dnes budeme mnohem častěji potkávat texty, které budou formálně dobré, ale přitom sterilní. Budou kvalitně napsané, ale budou vadit či nějak podprahově dráždit tím, že za nimi není cítit člověk. Jazykový model umí velmi dobře napodobit proces myšlení. Umí vytvořit odstavec, který působí rozumně. Umí dodat tři argumenty pro a tři proti, či napsat větu, která zní odborně. Slušná formulace ale neznamená, že někdo opravdu ví, co chce říct.
Ve zdravotnictví by nás to mělo zajímat víc než v mnoha jiných oborech. Medicína je ve své podstatě založena na práci s informacemi, různého druhu. Je to také práce s nejistotou, rizikem, odpovědností a důvěrou. Lékařská zpráva, informovaný souhlas, doporučení pro pacienta, odborné stanovisko nebo článek, jsou to záznamy rozhodování či vyjádření nějakého postoje. Jazykový model může pomoci s formulací, ale nemůže vědět, co autor skutečně viděl, proč se rozhodl právě takto a co je ochoten obhájit.
LLM může napsat text, ale nenese za něj odpovědnost. Nemá profesní pověst. Nemá vztah k pacientovi. Nemá zkušenost z reálného života. Lidská přidaná hodnota by se neměla redukovat na to, že člověk podle modelu opraví pár slov. Skutečná práce začíná dobře promyšleným a naformulovaným promptem (zadáním do chatu) a akceleruje po vygenerování návrhu. Člověk musí rozhodnout, co je hlavní a má zůstat a co je jen hezky napsaná vata. Kde se model tváří jistěji, než by měl. Kde zakryl problém zdvořilostí. Je rozdíl mezi přečtením a editací. Přečtení znamená, že text projdu a nenajdu zjevnou chybu. Editace znamená, že text vezmu jako cizí návrh a začnu mu nedůvěřovat. Ptám se, co v něm není. Co se v něm říká zbytečně. Co by mohl napadnout oponent. Co bych takhle sám nikdy nenapsal. Co zní dobře jen proto, že jsme si na tento druh jazyka zvykli.
Zvláštní riziko vidím v odborných a institucionálních textech. Nemocnice, fakulty, ministerstva, odborné společnosti i profesní komory už dnes produkují velké množství dokumentů. Mnohé jsou nutné a „provozní“. Mnohé nikdo pořádně nečte. LLM mohou tuto nadprodukci ještě posílit. Vznikne více metodik, více strategií, více shrnutí, více „doporučení“, více textů, které budou správně členěné a přiměřeně napsané. Jen se v nich bude hůř hledat, co je opravdu důležité. Přibývá dokumentů, které doporučují všechno najednou: posílit spolupráci, nastavit procesy, zajistit financování, podporovat inovace, respektovat regulaci, vzdělávat personál, sbírat data, vyhodnocovat dopady. Proti ničemu z toho nelze nic namítat. Skutečné stanovisko však vyžaduje, aby někdo určil pořadí důležitosti, něco vynechal, něco pojmenoval ostřeji a něco vzal na sebe.
Vědecké psaní na tom nebude lépe. Abstrakta budou uhlazenější, diskuse v článcích plynulejší, průvodní dopisy redakcím elegantnější. Současně se může ještě víc rozmnožit jazyk, který každý recenzent zná: „Jsou potřeba další studie, větší soubory, externí validace, prospektivní data, dlouhodobé sledování a vyhodnocení klinického dopadu.“ Čtenář přestává rozlišovat mezi skutečnou metodickou slabinou a povinnou větou na konci diskuse.
Ve výuce bude problém ještě zřetelnější. Studenti již odevzdávají a budou odevzdávat texty, které budou jazykově lepší než odpovídající skutečné porozumění popisovanému zadání. Učitelé budou číst práce, které vypadají slušně, ale není jasné, kolik z nich student opravdu promyslel. Řešením není AI studentům prostě zakázat. Budeme se muset naučit méně hodnotit samotný povrch textu a více schopnost vysvětlit, obhájit, použít a opravit vlastní závěr. Nejhorším možným scénářem je kontrola textu studentů napsaného LLM pomocí LLM, který využije učitel…
LLM nejsou nepřátelská technologie, pomáhají lidem, kteří mají dobré myšlenky, ale slabší jazyk. Pomáhají překonat prázdnou stránku. Pomáhají zkrátit dlouhý text. Pomáhají najít lepší strukturu. Pomáhají s cizím jazykem. Mohou posloužit jako rychlý oponent, který ukáže slabinu argumentace. Mohou být inspirací. V rukou člověka, který ví, co dělá, jsou užitečným nástrojem. Problém nastává, když lidé výstup přestanou považovat za návrh a začnou ho vnímat jako hotovou práci. Rozdíl je mezi těmi, kdo výstup jen přepošlou, a těmi, kdo ho převezmou jako surový materiál a připraví z něj produkt vlastní. S laděním textů generovaných pomocí LLM se dá hodně udělat pomocí vhodné formulace promptu. A není nutné se spokojit s prvním výstupem, lze ho dále v prostředí LLM chatu upravovat dalšími pokyny.
Sám bych pro práci s LLM doporučil několik jednoduchých pravidel.
1. Nespokojit se s prvním výstupem. Dobrý text vzniká až po dalších editacích, často spíš škrtáním než přidáváním.
2. Pokusit se v textu identifikovat „LLM vatu“ a polidštit znění. Často stačí jen odmazat část ze zbytnělého souvětí, význam zůstává, LLM pachuť mizí.
3. Doplňovat konkrétní realitu. Model napíše, že je třeba nastavit procesy. Autor musí napsat jaké. Model napíše, že je nutná odpovědnost. Autor musí říct čí.
4. Snažit se vnést do textu svůj styl. Každý člověk píše trochu jinak. Někdo stručně, někdo ostře, někdo opatrně, někdo pedagogicky. Jazykový model má tendenci tyto rozdíly vyhladit. U důležitého textu stojí za to položit si otázku: zní tohle jako já? Je použití LLM zjevné? Jak to bude vnímat adresát? Nevyvolá to v něm pocit, že jsem ho odbyl strojovou odpovědí?
5. Používat model proti modelu. Požádat o označení prázdných frází, slabých argumentů, příliš silných závěrů, možných námitek nebo míst, kde text zní genericky. Model je dobrý nejen jako písař, ale i jako protivník. Dokáže své slabé stránky identifikovat a popsat, jen jsou v současnosti tak integrální součástí jejich projevu, že je nejsou schopny zcela potlačit.
6. Ověřovat fakta mimo text. Plynulost je nebezpečná, protože vytváří dojem spolehlivosti. V medicíně to platí dvojnásob. Citace, doporučení, dávkování, indikace, legislativa, úhrady nebo názvy přípravků nelze převzít jen proto, že jsou vloženy do pěkné věty.
7. Podepisovat až po pečlivé kontrole. Za text nese odpovědnost autor a ne LLM. A autor by měl vědět, proč tam každá podstatná věta je. Důvěryhodně znějící nepravdy, tzv. halucinace, jsou již při užití LLM snad všeobecně známým fenoménem.
Je však také nutné zmínit, že řada věcí, které nyní ohledně umělé inteligence řešíme a diskutujeme, jsou poplatné době. Technologický vývoj je velmi dynamický a je možné (dokonce pravděpodobné), že v nějakém časovém horizontu nepůjde strojové psaní od lidské tvorby bez velkého úsilí rozlišit vůbec. Nebo bez další strojové analýzy…
LLM mohou být výborný pracovní nástroj. Mohou šetřit čas a zlepšovat komunikaci. Mohou pomoci lidem psát jasněji a rychleji. Poslední instancí má být pořád člověk, který rozumí situaci, zná adresáta, chápe rizika a je ochoten se pod text podepsat.
V době, kdy dobře vypadající text dokáže vyrobit skoro každý, bude hodnota jinde. V přesnosti. V konkrétnosti. V čase, který autor neinvestuje do psaní textu, ale do jeho úpravy. S rozumným a poučeným přístupem se stále dá dosáhnout velkých časových úspor. Důležité ale je, aby za textem byl poznat autor, ne nástroj, který umí velmi přesvědčivě skládat slova.
Autor: Doc. MUDr. David Zogala, Ph.D., Ústav nukleární medicíny 1. LF UK a VFN Praha, místopředseda pro vzdělávání České společnosti pro umělou inteligenci a inovativní digitální technologie ve zdravotnictví ČLS JEP, z. s.
P. S. Tento text vznikl poměrně dlouhou editací výstupu ChatGPT 5.5 (22. 6. 2026, OpenAI). Posoudit, nakolik se podařilo nešvary LLM eliminovat či alespoň do snesitelné míry rozředit – to nechávám na čtenářích. Za revizi textu děkuji prof. MUDr. Martinu Šámalovi, DrSc.
Foto: Shutterstock
reklama
reklama
Mohlo by vás zajímat


reklama
reklama